Quando abrimos um endereço na Web, uma sequência conhecida começa. Um nome é consultado. A consulta conduz a um endereço IP. Pacotes seguem até uma máquina capaz de responder. Uma conexão protegida autentica o servidor e transporta os dados.
Ao final, recebemos bytes de um lugar que fomos capazes de alcançar.
Essa arquitetura responde muito bem a uma pergunta: onde devo procurar? Ela não responde, por si só, a outra: o que exatamente recebi?
TLS autentica uma relação com uma identidade reconhecida para determinado nome. Assinaturas podem autenticar publicações. Aplicações podem conferir checksums e formatos. A Internet atual não é incapaz de verificar dados. O ponto é mais preciso: a identidade do objeto normalmente não integra a referência usada para localizá-lo.
Por isso, endereço e objeto mudam juntos em nossa experiência cotidiana. Se o servidor muda, o caminho precisa ser atualizado. Se o domínio desaparece, a referência deixa de funcionar. Se duas máquinas oferecem o mesmo arquivo, o usuário confia que ambas entregam a mesma coisa por mecanismos externos ao endereço.
O endereço nos leva ao fornecedor. Não identifica necessariamente o que ele fornece.
O endereço acumula papéis demais
Uma URL pode indicar esquema, autoridade, caminho e parâmetros. Ela é uma ferramenta expressiva, mas sua interpretação depende de infraestrutura e de estado que podem mudar.
O domínio depende de resolução. O endereço IP representa uma localização lógica para encaminhamento. O caminho é interpretado pelo servidor. O conteúdo de hoje pode ser substituído amanhã sem que a URL mude. A mesma representação pode aparecer em outro endereço com uma URL diferente.
Nada disso é um defeito acidental. Referências mutáveis são úteis. Queremos que o endereço de um jornal mostre a edição atual e que o perfil de uma organização acompanhe suas novas publicações. O problema aparece quando uma referência mutável também precisa funcionar como prova permanente do objeto referido.
Um endereço pode continuar igual enquanto o conteúdo muda. Um conteúdo pode continuar igual enquanto todos os seus endereços mudam.
São identidades diferentes.
Quando os bytes participam do nome
Uma alternativa é derivar a referência do próprio conteúdo. Em sua forma mais simples, uma função criptográfica recebe os bytes e produz um resumo. Qualquer alteração relevante produz outro resultado. Quem já conhece a referência pode repetir o cálculo e comparar.
A ideia antecede o PRP. A RFC 6920 padronizou nomes baseados em hash para identificar recursos independentemente do servidor e verificar a correspondência entre o nome solicitado e os dados recebidos. Sistemas como o IPFS usam identificadores de conteúdo para referenciar dados sem incorporar ao identificador o lugar em que estão armazenados.
Essa mudança parece pequena, mas altera a relação de confiança.
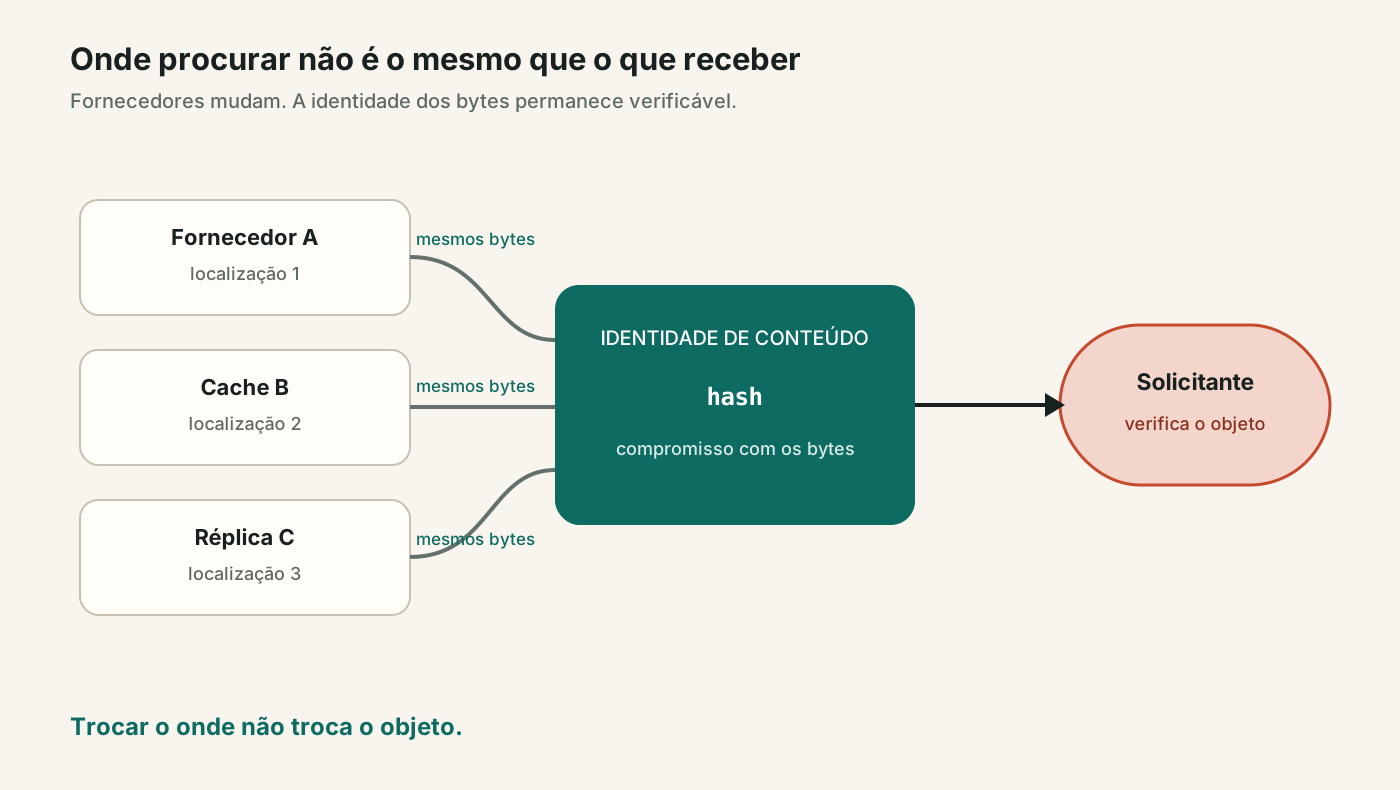
Se três fornecedores apresentam bytes para a mesma identidade de conteúdo, o solicitante não precisa aceitar a palavra de cada um sobre o objeto. Ele verifica a correspondência. Um cache não precisa ser a origem. Uma réplica não precisa conservar o endereço da primeira cópia. O canal ainda precisa resistir a interferência e indisponibilidade, mas deixa de ser a única garantia de integridade do objeto.
A confiança exigida do lugar diminui porque o objeto participa de sua própria verificação.
Uma cópia não se torna outro objeto
No modelo orientado a localização, mover dados exige atualizar referências ou manter uma cadeia de redirecionamentos. No modelo orientado a conteúdo, cópias idênticas preservam a mesma identidade de conteúdo.
Isso permite separar três funções:
- identificar: determinar qual sequência exata de bytes é procurada;
- descobrir: encontrar candidatos que declaram poder fornecê-la;
- transportar: obter os dados por algum caminho disponível.
O fornecedor pode mudar sem alterar o objeto. O transporte pode mudar sem alterar o objeto. Vários fornecedores podem coexistir sem receber poder para redefinir o objeto.
Essa separação também expõe uma diferença importante em relação ao artigo anterior. Bloquear uma localização pode tornar uma cópia inacessível por aquele caminho. Não revoga criptograficamente a identidade do conteúdo e não torna inválidas cópias obtidas de outros fornecedores.
Persistência, porém, não nasce de um identificador. Se ninguém conservar os bytes ou aceitar fornecê-los, o objeto continuará identificável e indisponível. Saber exatamente o que falta não faz o dado reaparecer.
Verificável não significa verdadeiro
Uma identidade de conteúdo responde a uma pergunta estreita: os bytes recebidos correspondem aos bytes comprometidos por esta referência?
Ela não prova quem criou o objeto. Não demonstra que uma notícia é verdadeira, que um programa é seguro, que uma imagem possui determinada licença ou que sua circulação é legítima. Também não informa, sozinha, por que alguém deveria confiar na referência inicial.
Essas perguntas pertencem a outras relações:
- uma assinatura pode vincular uma declaração a um agente;
- uma política pode autorizar acesso ou publicação;
- metadados podem declarar tipo, título, autoria e licença;
- uma referência controlada pode indicar qual versão é considerada atual;
- mecanismos de descoberta podem localizar fornecedores;
- decisões locais podem aceitar, ocultar ou rejeitar objetos.
Separar essas funções não as torna menos importantes. Torna cada decisão visível e verificável segundo a evidência apropriada, sem pedir que a localização circunstancial dos bytes represente todas elas ao mesmo tempo.
Um hash isolado ainda é insuficiente
Dizer “o hash deste arquivo” omite decisões necessárias. Qual algoritmo foi usado? Qual é o tamanho do resumo? O cálculo inclui apenas os bytes ou também um descritor? Como arquivos grandes são divididos? Como distinguir perfis que interpretam a mesma sequência de maneiras diferentes? Como verificar uma parte sem receber o objeto inteiro?
Um identificador interoperável precisa incorporar essas escolhas ou apontar inequivocamente para elas. Caso contrário, dois programas podem exibir o mesmo texto e calcular compromissos incompatíveis — ou aceitar interpretações que deveriam falhar.
Também existe uma consequência inevitável: conteúdo imutável não possui “edição no lugar”. Mudar um byte cria outra identidade de conteúdo. Essa propriedade preserva o passado, mas exige um mecanismo separado quando pessoas querem nomes estáveis para versões sucessivas.
Imutabilidade e atualização não são opostas. Elas ocupam camadas diferentes.
Conteúdo como caso de uso de ALIAS
No PRP, ALIAS é uma referência comum à qual múltiplos participantes independentes podem se associar. Seu texto pode representar um interesse, uma categoria de serviço ou um conteúdo específico. O protocolo define como esse texto é canonizado e transformado em uma referência SCIR da classe ALIAS.
Para encontrar um arquivo, a aplicação pode incluir nesse texto uma identidade de conteúdo definida por uma convenção compartilhada. Essa convenção determina como representar o algoritmo e o resumo criptográfico do objeto. Aplicações que usam o mesmo texto canônico e a mesma suite de referência formam o mesmo ALIAS, mesmo que estejam em máquinas ou redes diferentes.
Imagine três participantes que conservam cópias do mesmo documento. Eles podem se associar ao ALIAS correspondente. Quem procura o documento consulta essa referência e pode encontrar múltiplos candidatos. A aplicação escolhe um fornecedor, obtém os bytes e verifica sua correspondência com a identidade de conteúdo esperada. Se um fornecedor ficar indisponível, outro pode oferecer a mesma cópia sob a mesma referência.
A divisão de responsabilidades é direta: o PRP descobre participantes associados ao ALIAS; a aplicação define e verifica o conteúdo procurado. A suite usada para formar o ALIAS e o algoritmo usado para verificar o arquivo são escolhas distintas. Para transferências parciais ou simultâneas de vários fornecedores, as aplicações precisam compartilhar também as regras de divisão, recomposição e verificação dos blocos. Árvores de Merkle são uma opção para essa verificação.
Um participante pode se associar a um ALIAS sem possuir os bytes esperados. Por isso, a aplicação verifica o que recebe de cada fornecedor. Essa verificação permite usar réplicas e caches sem atribuir a eles autoridade para redefinir o objeto.
O nome que acompanha as versões
Pessoas raramente desejam memorizar identificadores criptográficos. Também querem perguntar pelo documento atual, pela última versão de um programa ou pela publicação mais recente de alguém.
A aplicação pode manter um ALIAS estável para encontrar participantes que distribuem as atualizações de uma publicação. Esses participantes fornecem, por exemplo, uma declaração assinada pelo editor indicando a identidade de conteúdo da edição atual. A aplicação confere a assinatura e as regras de versão antes de aceitar essa indicação. A autoridade vem da assinatura do editor; a associação ao ALIAS permanece aberta a múltiplos participantes.
O texto do ALIAS pode permanecer igual enquanto novas edições são anunciadas. Cada edição conserva sua própria identidade de conteúdo, permitindo verificar também cópias das versões anteriores.
Assim, “qual é a versão atual?” e “estes são os bytes daquela versão?” deixam de ser a mesma pergunta. A primeira depende de uma declaração atualizada. A segunda pode ser respondida localmente pela identidade de conteúdo.
Do lugar ao objeto
O artigo anterior mostrou como endereços se tornam substitutos imperfeitos para conteúdos, serviços e condutas. A identidade de conteúdo corrige uma parte dessa confusão: permite nomear e verificar o objeto sem torná-lo propriedade de uma localização.
Ela não elimina a rede subjacente, não garante disponibilidade e não decide políticas. Ainda precisamos encontrar agentes, escolher caminhos, estabelecer relações e avaliar declarações. Mas essas funções já não precisam fingir que o endereço de ontem é a identidade permanente de tudo o que passou por ele.
Quando sabemos o quê procuramos, podemos trocar o onde sem trocar o objeto.
O próximo artigo aplicará a mesma separação a pessoas e serviços. Se uma publicação não precisa pertencer ao servidor que a hospeda, por que a identidade de um agente deveria pertencer à plataforma que mantém sua conta?